智泊AI--Naive RAG

智泊AI–Naive RAG


1.Embeddings向量化

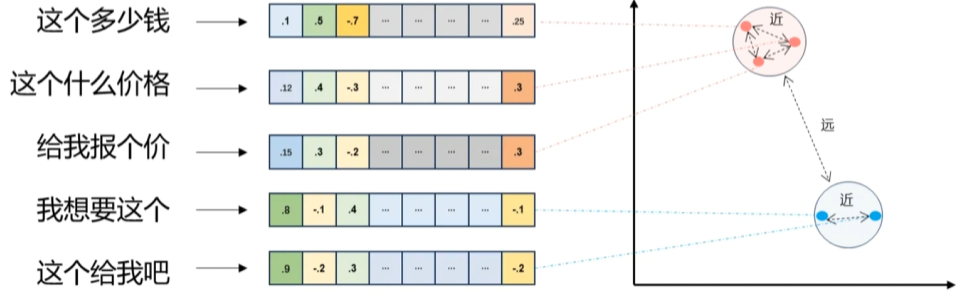
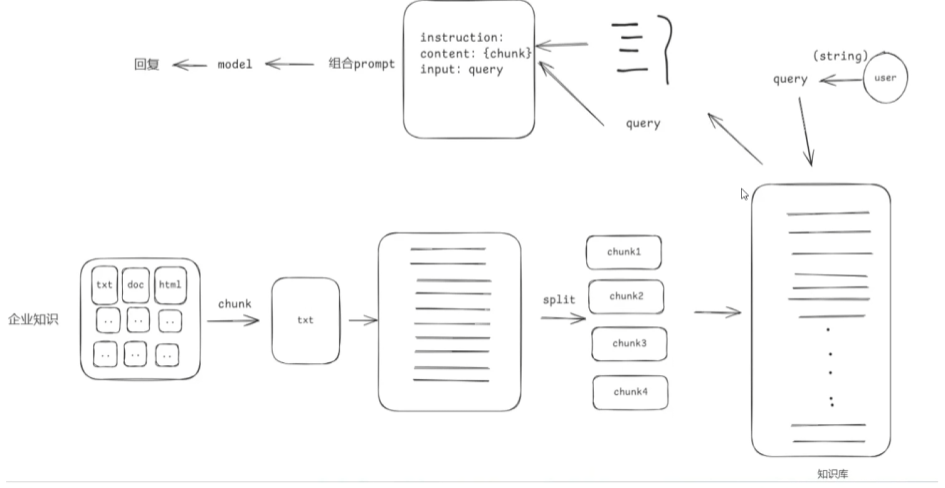
  向量检索:根据用户的输入,与向量数据库中存放的文本向量进行相似度匹配,返回最为相似的内容。

  文本嵌入模型(向量模型):将一个文本转换成一个「句向量」或「文本块向量」。

  (向量检索的准确度,和向量模型本身存在很大的关系。)

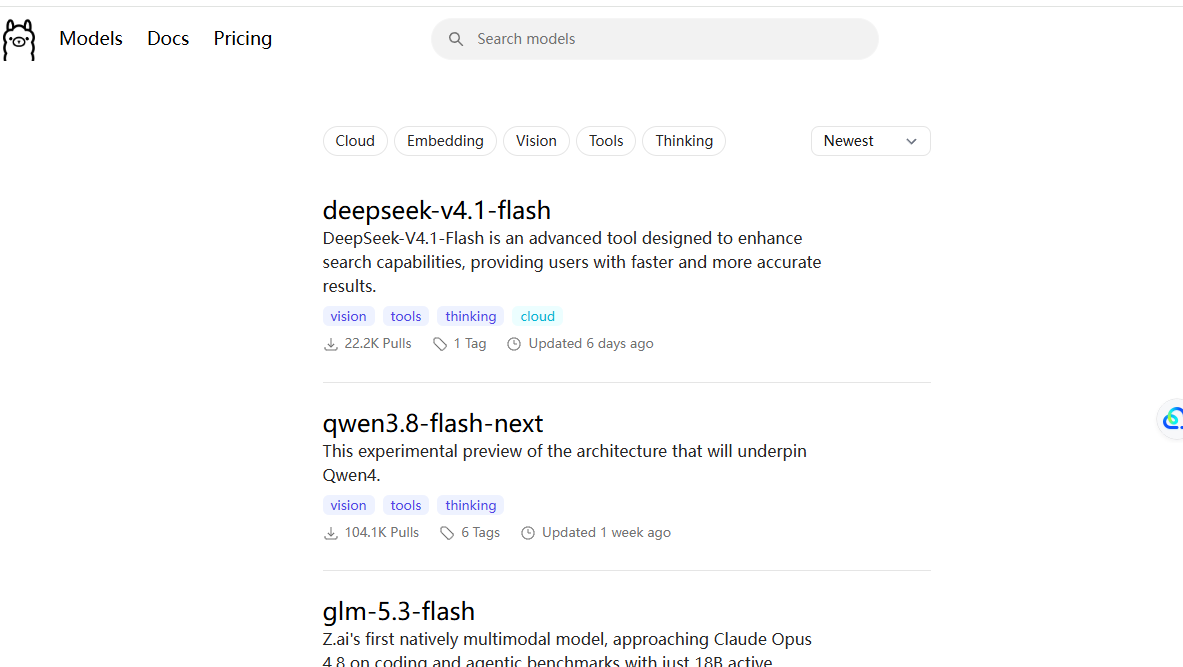
  目前向量模型的选择:

语种 推荐模型
中文 bge-m3、qwen-Embedding 系列模型
英文 bge-large-en、OpenAI-Embeddings


2.本地部署模型平台

  Ollama / vLLM 等:推理引擎,用于实际加载并运行上述向量模型。调用时主要关注以下参数:

  • 模型名称:即要使用的向量模型的名称。
  • 向量的维度:模型支持输出多少维度的向量。维度越大,承载的信息越多、准确度越高,但运行成本也越大;实际工作中需对不同维度做必要测试,选合适的即可。
  • 向量的批次大小:一次性能够并行处理的文本块数量,其并行机制与平台有关、与模型无关。
  • 单批次最大处理 token 数:不同平台的口径不同——
    • 阿里平台:指单个文本块的大小;
    • 某些平台:指一个批次的总大小。

注意:如果在生产环境中使用在线向量模型,一定要加入检测机制——存在「名称没变、底层已更新」的情况,会导致相同输入产出不同的向量。

  调用Ollama的代码示例:

1
2
3
4
5
6
7
8
9
10
11
# Ollama.py
# 用于调用Ollama模型
from ollama import Client


client = Client(host="http://127.0.0.1:11434")
response = client.embed(
'qwen3-embedding',
texts,
# options={'num_gpu': 0} #适用于有显卡,但是显存不足的情况下,指定不用GPU。
)

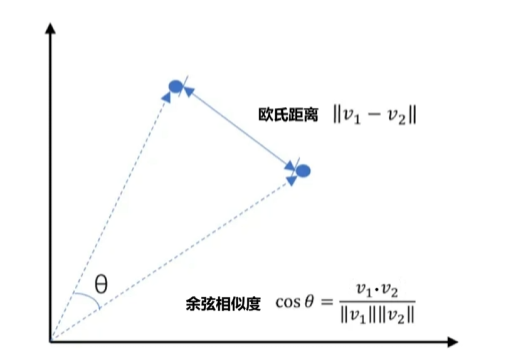
3.向量的相似度计算

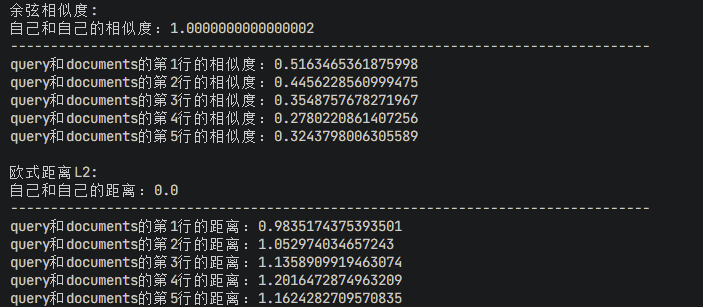
  生产中可基于这些算法构建测试集进行评测。(了解即可)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68

# RAG_向量的相似度计算.py
# 具体实现无需细究,了解模型对向量相似度的计算值即可
# 矩阵计算库 Numpy
import numpy as np
from numpy import dot # 点积
from numpy.linalg import norm # 线性代数,L2范数
from ollama import Client

client = Client(host="http://127.0.0.1:11434")

def cos_sim(a, b):
''' 余弦相似度 -- 越大越相似 '''
return dot(a, b) / (norm(a) * norm(b))

def l2(a, b):
'''欧式距离 -- 越小越相似'''
x = np.asarray(a) - np.asarray(b)
return norm(x)


def get_embeddings(texts, model='qwen3-embedding'):
# texts 是一个包含要获取嵌入表示的文本的列表,
# model 则是用来指定要使用的模型的名称
# 生成文本的嵌入表示。结果存储在data中。

# 基于bge-m3模型
client = Client(host="http://127.0.0.1:11434")
response = client.embed(
'qwen3-embedding',
texts,
# options={'num_gpu': 0} #适用于有显卡,但是显存不足的情况下,指定不用GPU。
)
data = response['embeddings']
return data

# print(data)
# 返回了一个包含所有嵌入表示的列表


# 且能支持跨语言
query = "国际争端"
# query = "global conflicts"
documents = [
"联合国就苏丹达尔富尔地区大规模暴力事件发出警告",
"土耳其、芬兰、瑞典与北约代表将继续就瑞典“入约”问题进行谈判",
"日本岐阜市陆上自卫队射击场内发生枪击事件 3人受伤",
"国家游泳中心(水立方):恢复游泳、嬉水乐园等水上项目运营",
"我国首次在空间站开展舱外辐射生物学暴露实验",
]

query_vec = get_embeddings([query])[0]
doc_vecs = get_embeddings(documents)

print("余弦相似度:")
print("自己和自己的相似度:" + str(cos_sim(query_vec, query_vec))) # query 和自己的相似度 为 1
print("-" * 80)
for i, vec in enumerate(doc_vecs):
print(f"query和documents的第{i+1}行的相似度:" + str(cos_sim(query_vec, vec))) # query和documents的每一行的相似度

print("\n欧式距离L2:")
print("自己和自己的距离:" + str(l2(query_vec, query_vec)))
print("-" * 80)
for i, vec in enumerate(doc_vecs):
print(f"query和documents的第{i+1}行的距离:" + str(l2(query_vec, vec)))


4.向量数据库

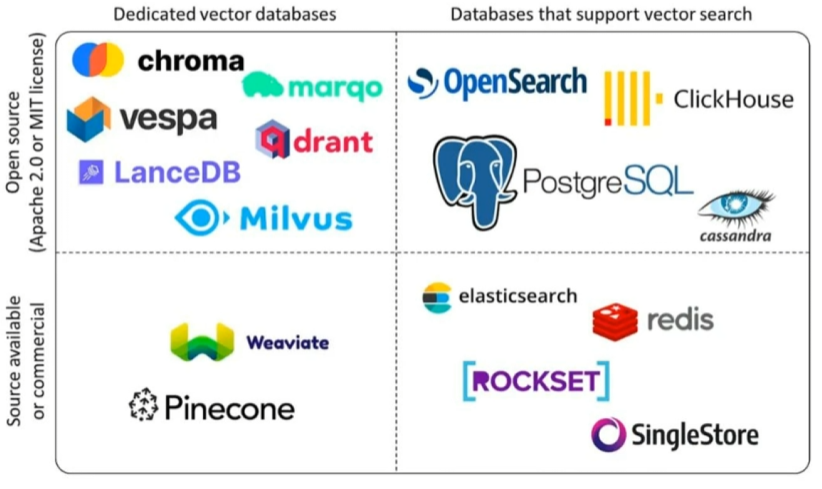
  在人工智能时代,向量数据库已成为了数据管理和AI模型不可或缺的一部分。向量数据库是一种专门设计用来存储和查询向量嵌入数据的数据库

4.1 向量数据库的选型

  在选型时主要考虑四个维度:

  • 是否开源;
  • 是否需要对接现有技术栈(MySQL、Redis 、elasticsearch等)
4.2 向量数据库的技术可行性
  • demo、学习:Chromadb;
  • 企业落地:Milvus。
4.3 常见的向量检索算法(主要从应用角度理解、便于调参):
  • HNSW:基于图的近似最近邻,查询快、内存占用高;
  • IVF:倒排文件,先聚类再检索,平衡型;
  • PQ:乘积量化,压缩向量以省内存;
  • diskANN:面向磁盘的大规模检索。

  数据库(含向量数据库)建立索引,本质都是为了提升查询速度。

4.4 top-k 与 top-p
  • top-k:按相似度排序,取前 K 条记录;
  • top-p:按相似度排序,取前 N 条记录,使这 N 条记录的相似度之和首次超过阈值 P 为止。
4.5 collection :

  collection本质是存放 embedding 向量 + 原文 + 元数据的一个「库中库」,在做 RAG 时,把知识切片、向量化后塞进某个 collection,检索时也在这个 collection 里搜——相当于「一本单独的知识册」

  • 添加文档:
1
2
3
4
5
self.collection.add(
embeddings=embeddings, # 每个文档的向量(必须)
documents=documents, # 文档的原文(可选)
ids=[f"id{i}" for i in range(len(documents))], # 每个文档的 id(必须)
)
  • 相似度检索:
1
2
3
4
results = self.collection.query(
query_embeddings=self.get_embeddings_batch([query]),
n_results=top_k # 返回前 5 个最相似的结果
)
4.6 一次简单的向量数据库调用

  在真正的企业落定中,离线向量化和在线查询是需要分开的,这里仅仅是结合进行初步的了解

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
# chromaDB使用.py
import chromadb
from ollama import Client
from chromadb.config import Settings
from langchain_text_splitters import RecursiveCharacterTextSplitter

from models import *


# 1.加载文档,读取数据
with open('../Data/deepseek百度百科.txt', 'r', encoding='utf-8') as f:
content = f.read()
print(len(content)) # 20899


# 负责和向量数据库打交道,接收文档转为向量,并保存到向量数据库中,然后根据需要从向量库中检索出最相似的记录
class MyVectorDBConnector:
# 初始化,传入集合名称,和向量化函数名
def __init__(self, collection_name):
# 当前配置中,数据保存在内存中,如果需要持久化到磁盘,需使用 PersistentClient创建客户端
chroma_client = chromadb.Client(Settings(allow_reset=True))
# 持久化到磁盘
# chroma_client = chromadb.PersistentClient(path="./chroma_data")
# 为了演示,实际不需要每次 reset()
# chroma_client.reset()

# 创建一个 collection
self.collection = chroma_client.get_or_create_collection(name=collection_name,
# 向量相似度计算方法: l2(默认), cosine, ip
metadata={'hnsw:space': 'l2'})

# # 连接大模型的客户端
# self.client = get_normal_client()

# 使用本地Ollama
self.client = Client(host="http://127.0.0.1:11434")

# 向量化
def get_embeddings(self, texts, model=ALI_TONGYI_EMBEDDING_V4, dimensions=1024):
# # 封装 OpenAI 的 Embedding 模型接口
# data = self.client.embeddings.create(input=texts, model=model, dimensions=64).data
# return [x.embedding for x in data]

# 使用本地Ollama
data = self.client.embed(input=texts, model="bge-m3", dimensions=dimensions)['embeddings']
return data

# 批量向量化:get_embeddings函数的变体版,因为各个模型对一次能处理的文本条数有限制且每个平台不一致,新增一个batch_size参数用以控制。
def get_embeddings_batch(self, texts, model=ALI_TONGYI_EMBEDDING_V4, batch_size=10, dimensions=1024):
# 57 文档块
all_embeddings = []
for i in range(0, len(texts), batch_size):
# texts[0:10],texts[10:20],texts[20:30],texts[30:40],texts[40:50],texts[50:60]
batch_text = texts[i : i+batch_size]

# data = self.client.embeddings.create(input=batch_text, model=model, dimensions=dimensions).data
# all_embeddings.extend([x.embedding for x in data])

data = self.client.embed(input=batch_text, model="bge-m3", dimensions=dimensions)['embeddings']
all_embeddings.extend(data)

return all_embeddings

# 添加文档与向量
def add_documents(self, documents):
'''向 collection 中添加文档与向量'''
embeddings = self.get_embeddings_batch(documents)

self.collection.add(
embeddings=embeddings, # 每个文档的向量
documents=documents, # 文档的原文
ids=[f"id{i}" for i in range(len(documents))], # 每个文档的 id
)
print("self.collection.count():", self.collection.count())

# 检索向量数据库
def search(self, query, top_k):
''' 检索向量数据库
query是用户的查询,
top_k指查出top_k个相似高的记录
'''
results = self.collection.query(
query_embeddings=self.get_embeddings_batch([query]),
n_results=top_k
)
return results

#查询存储在向量数据库的数据。仅限于测试,实际使用中,请勿使用。该方法会返回向量数据库中的所有数据,包括文档内容、向量、元数据和ID。
def get(self,count):
results = self.collection.get(include=["documents", "embeddings", "metadatas"], limit=count)
return results


# 创建一个向量数据库对象
vector_db = MyVectorDBConnector("demo")


# 2.切分文档
splitter = RecursiveCharacterTextSplitter(
chunk_size=500, # 分割长度
chunk_overlap=50, # 重叠长度 /重叠窗口大小
separators=["\n\n", "\n", "。", "?", ",", ""],
)
texts = splitter.split_text(content)
# for i, chunk in enumerate(texts):
# print(f"块 {i + 1} - 长度{len(chunk)},内容: {chunk}")
# exit()

# 3.将文档存入向量数据库
# 向 向量数据库 中添加文档
vector_db.add_documents(texts)

# 4.查看向量数据库中的数据(仅为了满足测试需要。)
alldata = vector_db.get(count=1)
print("数据库内的数据为:\n" + str(alldata))
print('-' * 100)

# 5. 开始检索
# user_query = "DeepSeek的全称是什么?"
user_query = "deepseek相继发布了哪些模型"
# user_query = '360集团创始人周鸿祎说了什么?'
results = vector_db.search(user_query, 5)
print(results)
print('-' * 100)

# results['documents'] :
for i in results['documents'][0]:
print(i + "\n----\n")

# 相关文档
contents = '\n'.join(results['documents'][0])

# 6. llm
prompt = f"""
你是一个问答机器人。
你的任务是根据下述给定的已知信息回答用户问题。
确保你的回复完全依据下述已知信息。不要编造答案。
如果下述已知信息不足以回答用户的问题,请直接回复"我无法回答您的问题"。

已知信息:
{contents}

----
用户问:
{user_query}

请用中文回答用户问题。
"""
print(prompt)
print('-' * 100)

def get_completion(prompt, model=ALI_TONGYI_MAX_MODEL):
'''封装 openai 接口'''
messages = [{"role": "user", "content": prompt}]

# # 使用百炼平台。
client = get_normal_client()
response = client.chat.completions.create(
model=model,
messages=messages,
temperature=0, # 模型输出的随机性,0 表示随机性最小
)
return response.choices[0].message.content

response = get_completion(prompt)
print(response)


智泊AI--Naive RAG
https://one-null-pointer.github.io/2026/08/21/智泊AI--Naive RAG/
Author
liaoyue
Posted on
August 21, 2026
传送口