智泊AI–Langchain(一)
0.安装环境变量 这里使用的是 Langchain 1.0 版本,以下是涉及到的依赖版本,放到 requirements.txt 文件中,执行 pip install -r .\requirements.txt 即可安装。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
aiofiles==24.1.0
1.什么是Langchain Langchain 是一个用于构建由 LLM 提供支持的代理和应用程序的框架。作用是简化 LLM 应用的开发难度,方便开发者快速地开发复杂的 LLM 应用。
官网:https://www.langchain.com/langchain
从 Langchain 0.3 到 Langchain 1.0 的优化:
统一 Agent 创建接口 —— create_agent()
中间件系统(Middleware)—— 细粒度流程控制
标准化输出(.content_blocks)—— 无论使用哪家模型,输出统一为结构化内容块
结构化输出原生支持 —— 将结构化输出直接集成到主循环中
基于 LangGraph 的底层架构 —— Agent 实际是 LangGraph 编排的状态图(StateGraph)
包结构精简与迁移路径 —— 移除冗余模块,核心包更加轻量。旧版本功能(LLMChain,ConversationBufferMemory 等)迁移到了 langchain-classic
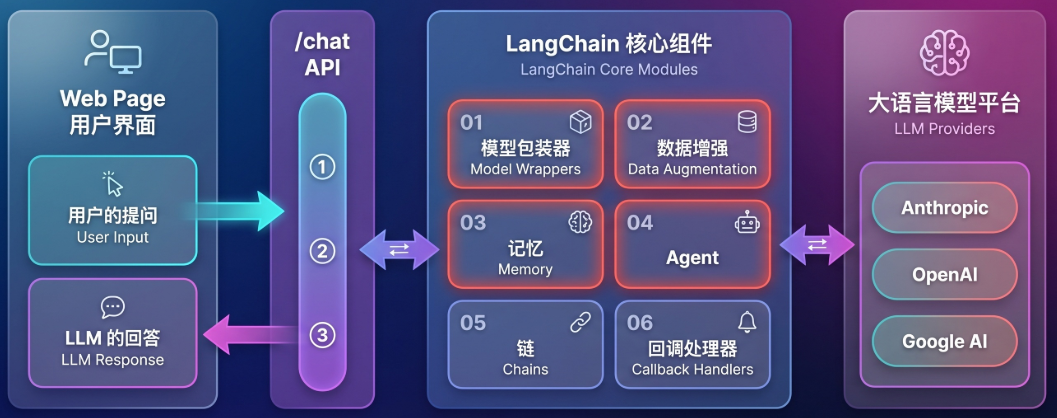
2.LangChain的核心组件 LangChain 的组件较多,大致上可以分为六大分类:
模型包装器(Model):与语言模型交互的接口,例如语言模型(Language Models)、提示词模版(Prompt Templates)、输出解析器(Output Parsers)等
数据连接(Data connection):与特定应用程序的数据进行交互的接口,例如文档加载器、文档切分、文本嵌入、矢量、检索器等
链(Chains):将组件组合实现端到端应用,链的存在允许我们将多个组件组合在一起,以创建一个单一的、连贯的应用程序
记忆(Memory):用于链的多次运行之间持久化应用程序状态
代理与工具(Agents):扩展模型的推理能力,用于复杂的应用的调用序列
中间件(Middleware):控制与自定义每个步骤的代理执行
3.Langchain 的模型包装器 传统调用模型与 langchain 调用对比:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
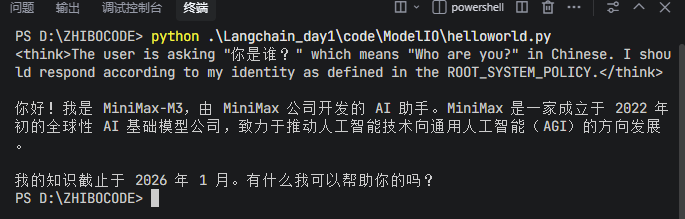
import osfrom openai import OpenAIfrom langchain_openai import ChatOpenAI"MINIMAX_API_KEY" ),"https://api.minimaxi.com/v1" ,"MiniMax-M3" ,0.7 ,"enable_thinking" : False },"你是谁?" )print (response.content)
这里需要注意的是 ChatTongyi 是 LangChain 专门为通义千问写的适配器,它内部已经把这些都硬编码好了,所以调用会更加方便,而 MiniMax 官方提供了 OpenAI 兼容协议,它在 LangChain 里没有专门的 ChatMinimax 类,所以只能用 ChatOpenAI 接口规范,并修改 url 和 model。
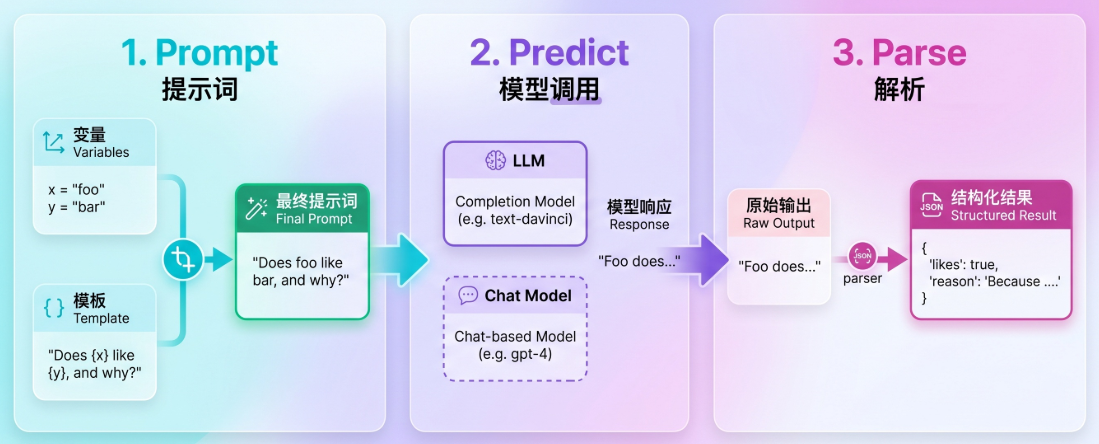
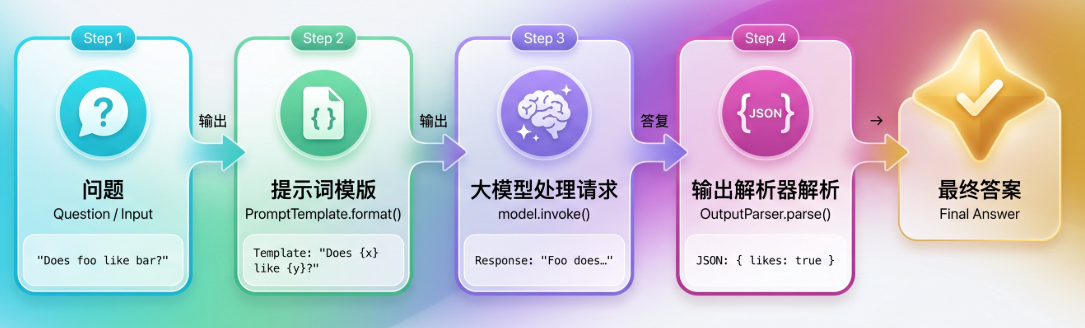
目前模型包装器主要包含三部分内容:提示词、模型调用、输出解析。
在模型调用中,Langchain 目前支持的模型有三大类:
非对话模型(LLM)包装器:也叫文本补全模型,基于 transformer 架构,通过大规模训练数据学习语言规律,只能一问一答,现在已经比较少用,OpenAI 的文本补全类 API 在 2023 年进行了最后一次更新,所以只需要知道即可
对话聊天模型(Chat Model)包装器:主要代表 OpenAI 的 ChatGPT 系列模型。这些模型通常由语言模型支持,但它们的 API 更加结构化,基于 LLM 构建,通过特定优化(如对话历史管理、角色区分)来提升对话连贯性和上下文理解能力,常见的聊天模型包装器为 ChatOpenAI、BaseChatModel 等
文本嵌入模型(Embedding Model):将文本作为输入并返回词向量,后续 RAG 内容会使用到
一个简单的模型调用实例:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
import osfrom langchain.chat_models import init_chat_modelfrom langchain_openai import ChatOpenAIfrom langchain_community.chat_models import ChatTongyi"MINIMAX_API_KEY" "https://api.minimaxi.com/v1" "MiniMax-M3" "MiniMax-M3" , model_provider="openai" ,"你是谁?" for chunk in response:print (chunk.content, end="" )
4.Langchain字符串提示词模版 在 Langchain 中,prompt template 是一个模版化的字符串,可以用在生成特定的提示,我们可以将变量插入到模版中,从而创建出不同的提示。
常见的提示词模版:
4.1 LLM提示模版 PromptTemplate 1 2 3 4 from langchain_core.prompts import PromptTemplate"你是一个翻译助手,请将以下问题翻译为{language}:{test}" )format (language="中文" , test="i love you." )
4.2 聊天提示模版 ChatPromptTemplate 常用的 Chat 提示模版,用于组合各种角色的消息模版,传入聊天模型。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 from langchain_core.prompts import PromptTemplate, ChatPromptTemplate, SystemMessagePromptTemplate, HumanMessagePromptTemplate, AIMessagePromptTemplate"你是一个翻译助手,请将用户的问题翻译为{language}" ),"{input}" ),format (input ="i love you." , language="中文" )
4.3 少样本提示模版 FewShotPromptTemplate 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 from langchain_core.prompts import PromptTemplate, ChatPromptTemplate, FewShotPromptTemplate, SystemMessagePromptTemplate, HumanMessagePromptTemplate, AIMessagePromptTemplate"input" : "如何重置密码?" , "output" : "密码重置可以通过绑定邮箱重置密码,也可以通过手机号重置密码" },"input" : "我的设备无法开机怎么办?" , "output" : "故障排除步骤:1.可能是遥控器电池没电,2.确认电源状态,3.确认设备是否被锁屏" },"input" : "这款产品是否有夜间模式?" , "output" : "这款不提供夜间模式,请选择xx款式的产品" },"用户问题: {input} 对应回答: {output}" "你是一个智能客服, 能够根据用户问题给出答案," ,"现在给你用户提问: {input} ,请告诉我对应的结果:" ,"input" ]format (input ="这款产品有防水模式?" )print ('-' *50 )
4.4 变量分段设置参数partial 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 from langchain_core.prompts import PromptTemplate, ChatPromptTemplate, FewShotPromptTemplate, SystemMessagePromptTemplate, HumanMessagePromptTemplate, AIMessagePromptTemplate"请从知识库中的文章设置问题,要求文章时间在{date}之后的,问题为{input}" "2008-08-08" )print (half_prompt)format (input ="这款产品有防水模式?" ))
5.Langchain的输出解析器 Output Parser 是 LLM 链里”LLM 吐出来的文本”和”程序真正要用的结构化数据”之间的一层翻译/适配器。为什么需要它?因为 LLM 只认识字符串——你问它”提取姓名和年龄”,它给你一段 姓名:张三,年龄:25 的自然语言。但你的代码要做 if person.age > 18:、要存数据库、要调 API,这些都吃不了裸文本。Output Parser 就是把”文本”可靠地变成 Person(name=”张三”, age=25) 这种对象。目前常见的解析器有:字符串解析器,CSV 解析器,json 解析器,日期解析等,我们也可以通过自定义去构造需要的解析器内容。
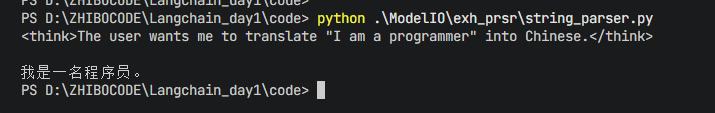
5.1 字符串解析器:StrOutputParser 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 import osfrom langchain_classic.output_parsers import DatetimeOutputParserfrom langchain_openai import ChatOpenAIfrom langchain_core.prompts import PromptTemplatefrom langchain_core.output_parsers import CommaSeparatedListOutputParser, JsonOutputParser, StrOutputParserfrom models import get_minimax_model_client"你是一个翻译助手,请讲以下内容翻译成{language}:{text}" )"language" : "中文" , "text" : "I am a programmer" })print (result)
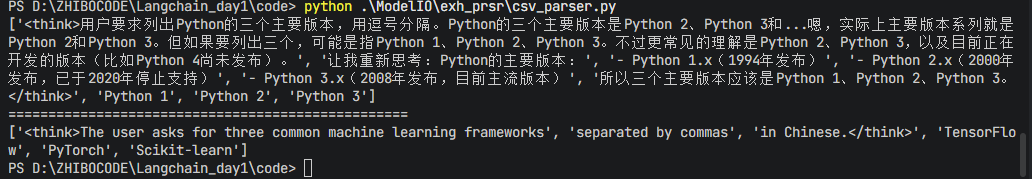
5.2 CSV解析器:CommaSeparatedListOutputParser 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 import osfrom langchain_openai import ChatOpenAIfrom langchain_core.prompts import PromptTemplate, ChatPromptTemplate, FewShotPromptTemplate, SystemMessagePromptTemplate, HumanMessagePromptTemplate, AIMessagePromptTemplatefrom langchain_core.output_parsers import CommaSeparatedListOutputParser, JsonOutputParser, StrOutputParserfrom models import get_minimax_model_client"system" , "你是一个专业的程序员" ),"user" , "{input}" )print (chain.invoke({"input" : "列出Python的三个主要版本, 用逗号分隔" }))print ("=" *50 )print (chain.invoke({"input" : "列举三个常见的机器学习框架, 用逗号分隔" }))
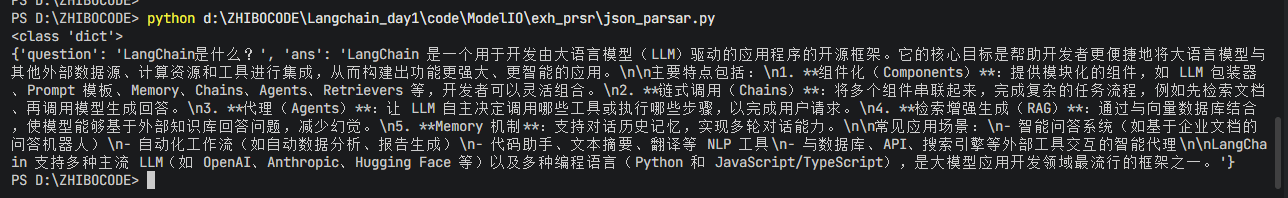
5.3 json解析器:JsonOutputParser 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 from langchain_core.prompts import ChatPromptTemplatefrom langchain_core.output_parsers import JsonOutputParser, StrOutputParserfrom models import get_minimax_model_client"system" , "你是一个专业的程序员" ),"user" , "{input}" )"input" : "langchain是什么? 问题用question 回答用ans 返回一个JSON格式" })print (type (result))print (result)
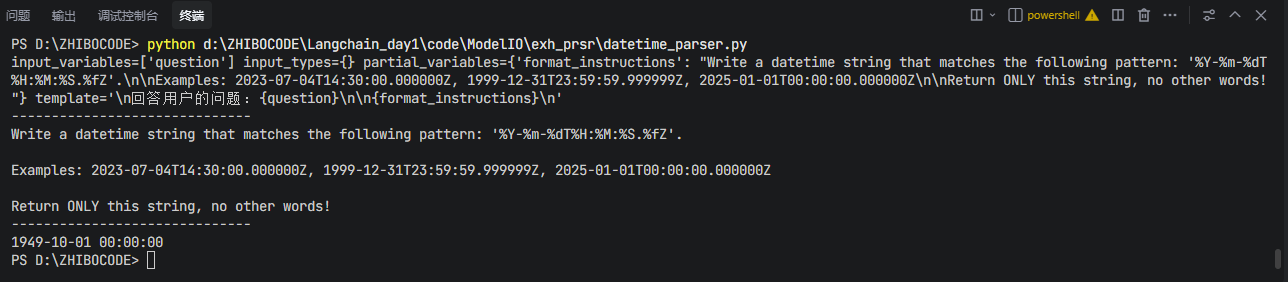
5.4 日期时间解析器:DatetimeOutputParser 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 import refrom langchain_classic.output_parsers import DatetimeOutputParserfrom langchain_core.output_parsers import StrOutputParserfrom langchain_core.prompts import PromptTemplatefrom langchain_core.runnables import RunnableLambdafrom models import get_minimax_model_client""" 回答用户的问题:{question} {format_instructions} """ "format_instructions" : output_parser.get_format_instructions()},print (prompt)print ("-" *30 )print (output_parser.get_format_instructions())print ("-" *30 )def extract_datetime (text: str ) -> str :r"<think>.*?</think>" , "" , text, flags=re.DOTALL)r"\d{4}-\d{2}-\d{2}T\d{2}:\d{2}:\d{2}\.\d+Z" ,return match.group(0 ) if match else cleaned.strip()"question" : "新中国是什么时候成立的?" })print (output)
这里需要注意,链里加一步清洗(先剥 <think>...</think>,再用正则精确匹配 %Y-%m-%dT%H:%M:%S.%fZ),把纯时间串交给 DatetimeOutputParser。
5.5 自定义结果解析器 这里以不同时间获取输出作为例子。
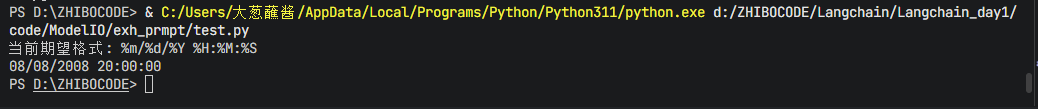
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 import refrom datetime import datetimeimport datetimefrom langchain_core.exceptions import OutputParserExceptionfrom langchain_core.output_parsers import BaseOutputParser, StrOutputParserfrom langchain_core.prompts import PromptTemplatefrom models import get_minimax_model_clientclass DateStringParser (BaseOutputParser[str ]):str = "%Y-%m-%d" def parse (self, text: str ) -> str :""" 接收模型的原始输出字符串,将其解析、验证并返回格式化后的字符串。 """ try :return dt_object.strftime(self.target_format)except ValueError as e:r"<think>.*?</think>" , "" , stripped_text, flags=re.DOTALL)r"\d{1,4}[-/]\d{1,2}[-/]\d{1,4}[T ]\d{1,2}:\d{2}:\d{2}(?:\.\d+)?Z?" ,if candidate:0 )"T" , " " ).rstrip("Z" ).replace("-" , "/" )try :return dt_object.strftime(self.target_format)except ValueError:pass raise OutputParserException(f"模型输出的日期格式不正确。期望格式为 '{self.target_format} ',但收到了: '{stripped_text} '. 错误: {e} " def get_format_instructions (self ) -> str :"""返回给 LLM 的指令,要求它输出特定的日期格式。""" print ("当前期望格式:" , self.target_format)return (f"请严格按照以下格式输出日期:'{self.target_format} '.\n" f"例如: {example_date} \n" f"只返回日期字符串,不要包含任何其他文本、空格或标点符号!" "%m/%d/%Y %H:%M:%S" )""" 回答用户的问题:{question} {format_instructions} """ "format_instructions" : date_parser.get_format_instructions()},"北京夏季奥运会的开幕时间是?" "question" : question})print (output)
可以自己定义类进行操作,主要是定义其中的:
parse(将大模型返回结果,按照要求解析成想要的格式)
get_format_instructions(规范大模型的输出格式,返回的是提示词)
6.Langchain的链式 链的作用是将提示词模版、模型包装器和输出解析器串联起来,利用了提示模版格式化输入,将格式化后的字符串传递给了 LLM 模型,并返回了 LLM 的输出。
本质上就是单向线性的链表。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 import osfrom langchain_openai import ChatOpenAIfrom langchain_core.prompts import PromptTemplatefrom langchain_core.output_parsers import StrOutputParser"MINIMAX_API_KEY" "https://api.minimaxi.com/v1" "MiniMax-M3" "你是一个翻译助手,请讲以下内容翻译成{language}:{text}" )"language" : "中文" , "text" : "I am a programmer" })print (result)
使得整个处理过程更加高效与便捷。
7.Langchain的部署 在开发完一个大模型的应用程序后,如何让这个程序和其他的应用程序一起协同工作,完成企业的复杂业务呢。
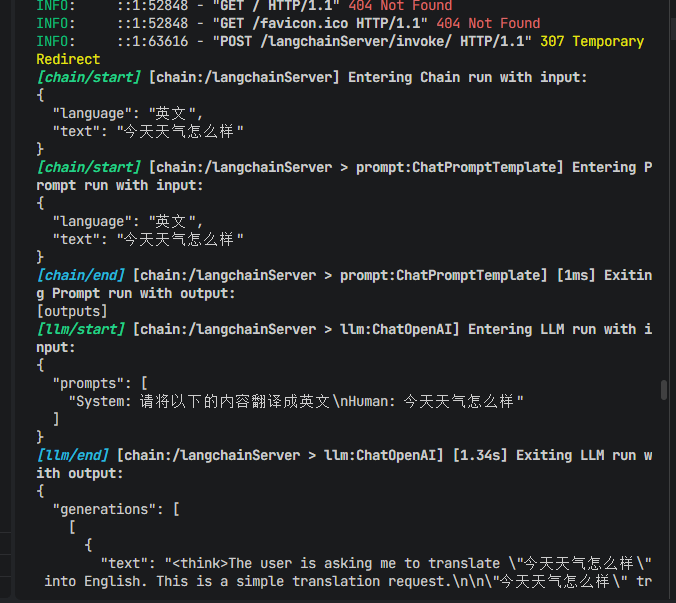
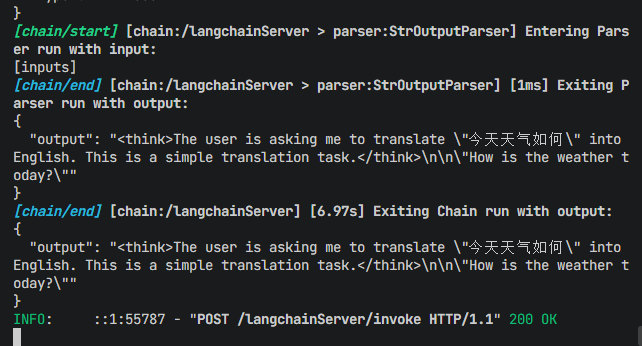
7.0 开启Langchain应用程序的调试功能(非必须) 1 2 3 from langchain_core.globals import set_debugTrue )
后续如果需要复杂和实时的监控可以借助 LangSmith 进行,但是这玩意收费。
7.1 发布我们的应用程序 FastAPI 是 python 中用于 web 开发的技术框架。add_routes 是 LangServer 当中的 api,LangServer 是 Langchain 中用于服务的内容。
1 2 3 4 5 6 7 8 "基于LangChain的服务" ,version="V1.5" ,description="翻译服务" )"/langchainServer" )if __name__ == "__main__" :import uvicorn"localhost" , port=8000 )
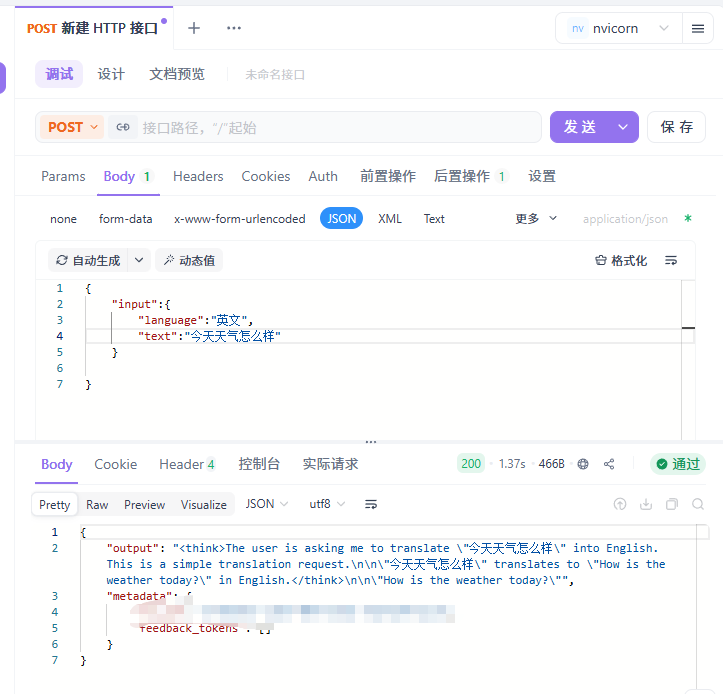
7.2 访问我们的应用程序 通过 HTTP 访问、客户端访问。
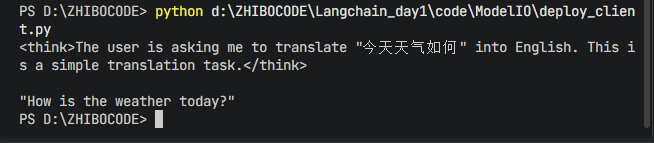
我们也可以使用 langserver 中的 RemoteRunnable 进行访问:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 '''比如在postman或者apifox中访问http://localhost:8000/tslServer/invoke 在body中选择json,然后输入 { "input": { "language":"意大利文", "text":"为了部落!" } }''' from langserve import RemoteRunnableif __name__ == "__main__" :"http://localhost:8000/langchainServer" )print (client.invoke({'language' : '英文' , 'text' : '今天天气如何' }))