智泊AI–Langchain(二)
0.前言 本章节主要是针对链(Chain)相关知识点进行学习。
1.什么是链 本质上,LangChain 的名字源自于其框架的核心设计实录,用链(Chain)将大语言模型开发的各个组件链接起来,以构建复杂的应用程序。
2.链的输出方式 LCEL 被称为 LangChain 表达式(LangChain Expression Language),所有被链起来的组件,如大语言模型、输出解析器、检索器、提示词模版等,都支持以下三种方法的调用:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
from langchain_community.chat_models import ChatOpenAIfrom langchain_core.output_parsers import StrOutputParserfrom langchain_core.prompts import ChatPromptTemplatefrom models import get_lc_model_clientTrue )"system" , "你是一个精通ai开发的高手" ),"human" , "{input}" ),for chunk in chain.stream({"input" : "你好" }):print (chunk, end="" , flush=True )print ()
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
from langchain_community.chat_models import ChatOpenAIfrom langchain_core.output_parsers import StrOutputParserfrom langchain_core.prompts import ChatPromptTemplatefrom models import get_lc_model_client"system" , "你是一个精通ai开发的高手" ),"human" , "{input}" ),print (chain.invoke({"input" : "你好" }))
batch:接受批量输入返回输出列表(不利于记忆操作)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
from langchain_community.chat_models import ChatTongyifrom langchain_core.prompts import ChatPromptTemplatefrom langchain_openai import ChatOpenAIfrom langchain_core.output_parsers import StrOutputParserimport timefrom models import get_lc_model_client"用一句话介绍{topic}" )"人工智能" , "区块链" , "量子计算" , "基因编辑" ]"topic" : topic} for topic in topics] for i, res in enumerate (batch_results):print (f"{topics[i]} : {res} " )
3.链的组合方式 链的组合主要有两种,一种是使用 | 直接操作(也是最为常见的),另一种则是使用 RunnableSequence。
1 2 3 4 5 6 7 8 9 print (chain.invoke({"topic" : "人工智能" }))from langchain_core.runnables import RunnableSequenceprint (chain2.invoke({"topic" : "人工智能" }))
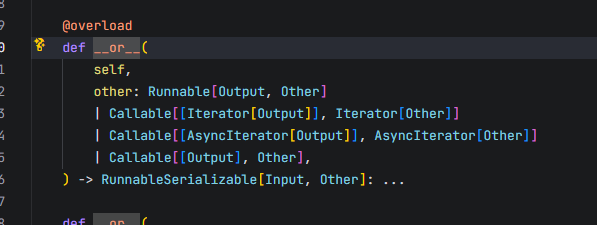
两者本质相同,| 本质上是一个或运算,但是被进行了重写,指向的 RunnableSerializable 就是所有链的父类,效果是一样的,| 只是改变代码写入方式。
4.函数的链化 很多时候,LangChain 组件并未能提供我们所需要的功能,这就需要我们自己写函数进行实现,实现函数需要将其加入到链中,这就需要使用 RunnableLambda 或者 @chain。
@chain 装饰器是 RunnableLambda(func) 的语法糖。两者作用完全一样,都是把普通函数包成可被 | 串联的 Runnable。
4.1 RunnableLambda的写法 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 from base64 import b16decodefrom operator import itemgetterfrom langchain_community.chat_models import ChatTongyifrom langchain_core.output_parsers import StrOutputParserfrom langchain_core.prompts import ChatPromptTemplate, promptfrom langchain_core.runnables import RunnableLambda, chainfrom models import get_lc_model_clientdef length_function (text ):return len (text)def _multiple_length_function (text1, text2 ):return len (text1) * len (text2)def multiple_length_function (_dict ):return _multiple_length_function(_dict ["text1" ], _dict ["text2" ])"计算两个字符串的长度的乘积 {a} * {b} = ? 计算结果是多少?" )"k1" ) | RunnableLambda(length_function)"text1" : itemgetter("k1" ) , "text2" : itemgetter("k2" )} | RunnableLambda(multiple_length_function)"a" :a1,"b" :b1} | prompt | model | outprint (chain.invoke({"k1" : "hello" , "k2" : "world" }))
4.2 @chain的写法 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 from base64 import b16decodefrom operator import itemgetterfrom langchain_community.chat_models import ChatTongyifrom langchain_core.output_parsers import StrOutputParserfrom langchain_core.prompts import ChatPromptTemplate, promptfrom langchain_core.runnables import RunnableLambda, chainfrom models import get_lc_model_client@chain def length_function (text ):return len (text)def _multiple_length_function (text1, text2 ):return len (text1) * len (text2)@chain def multiple_length_function (_dict ):return _multiple_length_function(_dict ["text1" ], _dict ["text2" ])"计算两个字符串的长度的乘积 {a} * {b} = ? 计算结果是多少?" )"k1" ) | length_function"text1" : itemgetter("k1" ) , "text2" : itemgetter("k2" )} | multiple_length_function"a" :a1,"b" :b1} | prompt | model | outprint (chain.invoke({"k1" : "hello" , "k2" : "world" }))
在使用场景上,如果是别人定义的函数,我们可以直接使用 RunnableLambda;如果是自己定义的函数则使用 @chain。
5.链的并行执行 在之前的章节中,我们使用了 RunnableSequence,将所有组件或者任务进行了顺序执行,但在业务场景中,我们往往希望多个任务能够同时进行,这时就需要用到 RunnableParallel 或者 RunnableMap,调用办法是一样的。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 from langchain_core.globals import set_debugfrom langchain_core.runnables import RunnableParallel, RunnableMap, RunnableLambdaTrue )def add_one (x: int ) -> int :return x + 1 def mul_two (x: int ) -> int :return x * 2 def mul_three (x: int ) -> int :return x * 3 print (chain.invoke(2 ))
6.链的额外数据传递 RunnablePassthrough 类允许我们在 LangChain 的链的执行过程中传递数据。
6.1 不改变输入数据 确保数据保持不变,直接用于后续步骤的输入。
1 2 3 4 5 6 7 8 9 10 from langchain_core.runnables import RunnableParallel, RunnablePassthroughprint (chain.invoke("hello world" ))
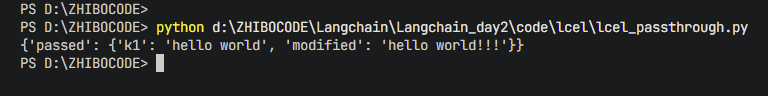
6.2 改变输入数据 通过 assign 对数据增强,会在原有的数据基础上加入新的内容形成一个字典。
1 2 3 4 5 6 7 8 9 10 11 from langchain_core.runnables import RunnableParallel, RunnablePassthroughlambda x: x["k1" ]+"!!!" ),print (chain.invoke({"k1" : "hello world" }))
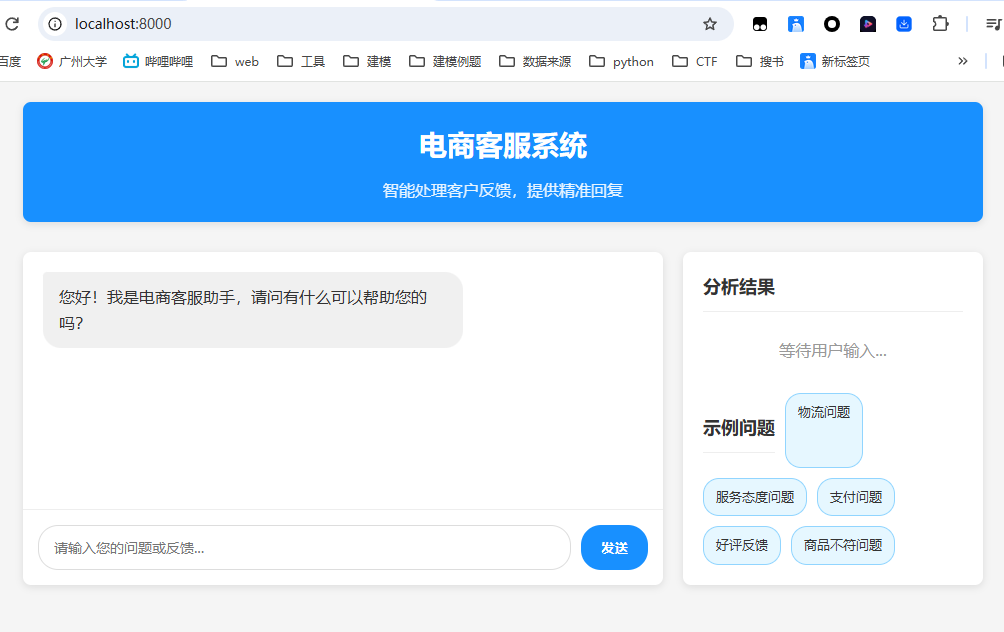
7.智能客服实战拆解 7.1 定位需求
7.2 准备前置工具 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 192 193 194 195 196 197 198 199 200 201 202 203 204 205 206 207 208 209 210 211 212 213 214 215 216 217 218 219 220 221 222 223 224 225 226 227 228 229 230 231 232 233 234 from doctest import debugimport osimport reimport jsonimport timeimport langchainfrom langchain_core.runnables import RunnableLambda, RunnableParallel, RunnablePassthroughfrom langchain_community.chat_models import ChatTongyifrom models import get_lc_model_clientfrom langchain_core.prompts import ChatPromptTemplatefrom langchain_core.output_parsers import JsonOutputParserfrom langchain_core.globals import set_debugTrue )0.2 , False , def call_model_with_retry (prompt, max_retries=3 , retry_delay=2 ):"""带错误重试的MiniMax-M3模型调用""" for attempt in range (max_retries):try :return response.contentexcept Exception as e:print (f"模型调用失败 (尝试 {attempt + 1 } /{max_retries} ): {str (e)} " )return "模型服务暂时不可用,请稍后再试。" def extract_order_id (text: str ) -> dict :"""使用千问模型提取订单ID""" f""" 你是一个电商订单处理专家,请从以下客户反馈中提取订单ID: {text} 订单ID通常是"ORD"开头的10位数字组合。如果找不到订单ID,返回"NOT_FOUND"。 请严格按JSON格式返回结果:{{"order_id": "提取结果"}} """ try :r'ORD\d{10}' , text)return {"order_id" : match.group(0 ) if match else "NOT_FOUND" }except :return json.loads(result.strip())def analyze_sentiment (text: str ) -> dict :"""使用千问模型进行情感分析""" f""" 请分析以下客户反馈的情感倾向: 「{text} 」 要求: 1. 判断情感类型:POSITIVE(积极)/NEUTRAL(中性)/NEGATIVE(消极) 2. 评估置信度(0.0-1.0) 3. 提取3个关键短语 返回JSON格式: {{ "sentiment": "情感类型", "confidence": 置信度, "key_phrases": ["短语1", "短语2", "短语3"] }} """ try :return resultexcept Exception as e:print (f"情感分析失败: {e} " )return {"sentiment" : "NEUTRAL" ,"confidence" : 0.7 ,"key_phrases" : []def classify_issue (text: str ) -> dict :"""使用千问模型进行问题分类""" f""" 作为电商客服专家,请对以下客户反馈进行分类: 「{text} 」 分类选项: - 物流问题:配送延迟、物流损坏等 - 产品质量:商品瑕疵、功能故障等 - 客户服务:客服态度、响应速度等 - 支付问题:扣款异常、退款延迟等 - 退货退款:退货流程、退款金额等 - 其他:无法归类的反馈 要求: 1. 选择最相关的1-2个分类 2. 按相关性排序 返回JSON格式:{{"categories": ["分类1", "分类2"]}} """ try :return resultexcept Exception as e:print (f"问题分类失败: {e} " )return {"categories" : ["其他" ]}def assess_urgency (text: str ) -> dict :"""使用千问模型评估紧急程度""" f""" 作为客服主管,请评估以下客户反馈的紧急程度: 「{text} 」 评估标准: - HIGH(高):包含"紧急"、"立刻"、"马上"或威胁投诉 - MEDIUM(中):表达强烈不满但无立即行动要求 - LOW(低):一般反馈或建议 返回JSON格式: {{ "urgency": "紧急级别", "sla_hours": 响应时限(小时), "reason": "评估理由" }} """ try :"sla_hours" ] = int (result["sla_hours" ])return resultexcept Exception as e:print (f"紧急度评估失败: {e} " )return {"urgency" : "MEDIUM" ,"sla_hours" : 24 ,"reason" : "评估失败" def generate_response (data: dict ) -> dict :print (data)""" 你是一名资深电商客服专家,请根据以下分析结果生成客户回复: ### 客户反馈原文: {feedback} ### 分析结果: - 订单ID:{order_id} - 情感倾向:{sentiment} (置信度:{confidence:.2f}) - 问题类型:{categories} - 紧急程度:{urgency} (需在{sla_hours}小时内响应) {key_phrases_section} ### 回复要求: 1. 根据情感倾向调整语气: - 积极反馈:表达感谢,适当赞美 - 消极反馈:诚恳道歉,明确解决方案 2. 包含订单ID和问题分类 3. 明确说明处理时限和后续步骤 4. 长度100-150字,使用自然口语 5. 结尾询问是否还有其他问题 请直接输出回复内容,不需要额外说明。 """ "key_phrases" , [])if key_phrases:"- 关键要点:" + "," .join(key_phrases[:3 ])else :"" format ("original_feedback" ],"order_id" ],"sentiment" ],"confidence" , 0.8 ),"、" .join(data["categories" ]),"urgency" ],"sla_hours" ],try :if data["urgency" ] == "HIGH" :f"[紧急] {response} " return {"final_response" : response,"assigned_team" : data["categories" ][0 ] if data["categories" ] else "General" ,"result" :dataexcept Exception as e:print (f"回复生成失败: {e} " )return {"final_response" : "感谢您的反馈,我们的团队将尽快处理您的问题。" ,"assigned_team" : "General"
7.3 构建LCEL处理链 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 """ 返回的数据格式: { "order_id": { "order_id": "ORD2024071501" # 或 "NOT_FOUND" }, "original_feedback": "原始反馈文本" } """ lambda x: x""" 返回的数据格式: { "sentiment": { "sentiment": "NEGATIVE", # 情感类型 "confidence": 0.92, # 置信度 "key_phrases": ["物流太慢", "承诺三天", "实际七天"] # 关键短语 }, "categories": { "categories": ["物流问题"] # 问题分类 }, "urgency": { "urgency": "HIGH", # 紧急程度 "sla_hours": 4, # 响应时限(小时) "reason": "包含紧急处理要求" # 评估理由 } } """ lambda x: analysis_chain.invoke(x["original_feedback" ])"original_feedback" : lambda x: x["original_feedback" ],"order_id" : lambda x: x["order_id" ]["order_id" ],"sentiment" : lambda x: x["analysis" ]["sentiment" ].get("sentiment" , "NEUTRAL" ),"confidence" : lambda x: x["analysis" ]["sentiment" ].get("confidence" , 0.8 ),"key_phrases" : lambda x: x["analysis" ]["sentiment" ].get("key_phrases" , []),"categories" : lambda x: x["analysis" ]["categories" ]["categories" ],"urgency" : lambda x: x["analysis" ]["urgency" ]["urgency" ],"sla_hours" : lambda x: x["analysis" ]["urgency" ]["sla_hours" ],"urgency_reason" : lambda x: x["analysis" ]["urgency" ].get("reason" , "" )
7.4 请求调用模块 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 from fastapi import FastAPI, HTTPExceptionfrom pydantic import BaseModelfrom fastapi.responses import FileResponse"电商客服系统" )class FeedbackRequest (BaseModel ):str str = "anonymous" @app.get("/" async def read_index ():return FileResponse(os.path.join(BASE_DIR, "index.html" ))@app.post("/process-feedback" async def process_feedback (request: FeedbackRequest ):try :return {"success" : True ,"processing_time" : f"{elapsed:.2 f} s" ,"result" : resultexcept Exception as e:raise HTTPException(500 ,f"处理失败: {str (e)} " if __name__ == "__main__" :
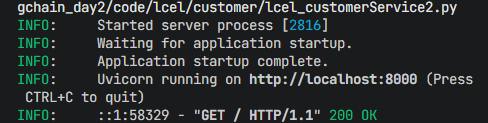
7.5 启动
8.预定义链 在 LangChain 中,针对 LCEL 链,已经提前做好了一些 LCEL 链,可以在以下链接查看官方介绍:
https://reference.langchain.com/python/langchain_classic/chains/
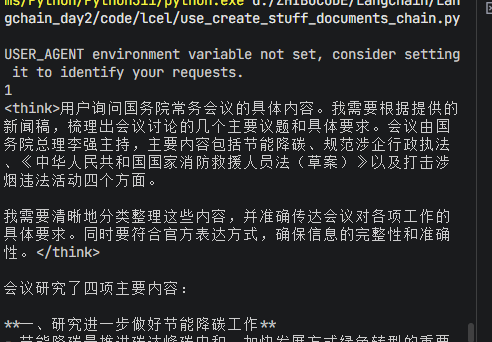
这里以 create_stuff_documents_chain 为例,作用是将多个文档内容合并成一个长文本,然后一次性交给 LLM 进行处理。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 from langchain_classic.chains.combine_documents import create_stuff_documents_chainfrom langchain_core.prompts import ChatPromptTemplateimport bs4from langchain_community.document_loaders import WebBaseLoaderfrom langchain_text_splitters import RecursiveCharacterTextSplitterfrom models import get_lc_model_client"system" , "根据提供的上下文: {context} \n\n 回答问题" ),"user" , "问题:{input}" ), "https://www.gov.cn/yaowen/liebiao/202512/content_7050416.htm" ,"parse_only" :bs4.SoupStrainer(id ="UCAP-CONTENT" )}1000 , chunk_overlap=50 )print (len (documents))"input" : "会议具体说了哪些内容?" , "context" : documents})print (res)
9.记忆层面 9.1 记忆的处理 记忆(Memory):用于链的多次运行之间持久化应用程序状态。
在新版本的 LangChain 提供了专门的消息历史组件 ChatMessageHistory。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 from langchain_core.output_parsers import StrOutputParserfrom langchain_core.prompts import ChatPromptTemplate, SystemMessagePromptTemplate, MessagesPlaceholder, \from langchain_openai import ChatOpenAIfrom langchain_community.chat_message_histories import ChatMessageHistoryfrom models import get_lc_model_client"你是人工智能助手" ),"messages" ), while True :input ("用户:" )if user_input == "exit" :break 'messages' : chat_history.messages})print ("chat_history:" ,chat_history.messages)print (f"大模型回复》》》:{response} " )
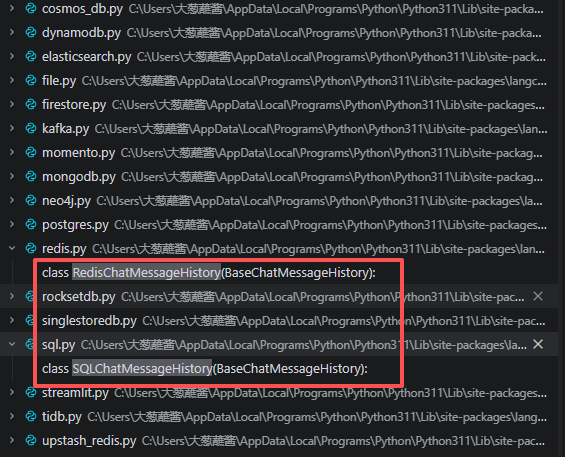
9.2 记忆的持久化存储 通过 ChatMessageHistory 组件即可进行简单历史消息存储,而除此之外,如果要实现记忆的持久化存储,就需要使用到数据库,这些都是基于 BaseChatMessageHistory 的子类,这里以 redis 作为例子,使用 RedisChatMessageHistory。
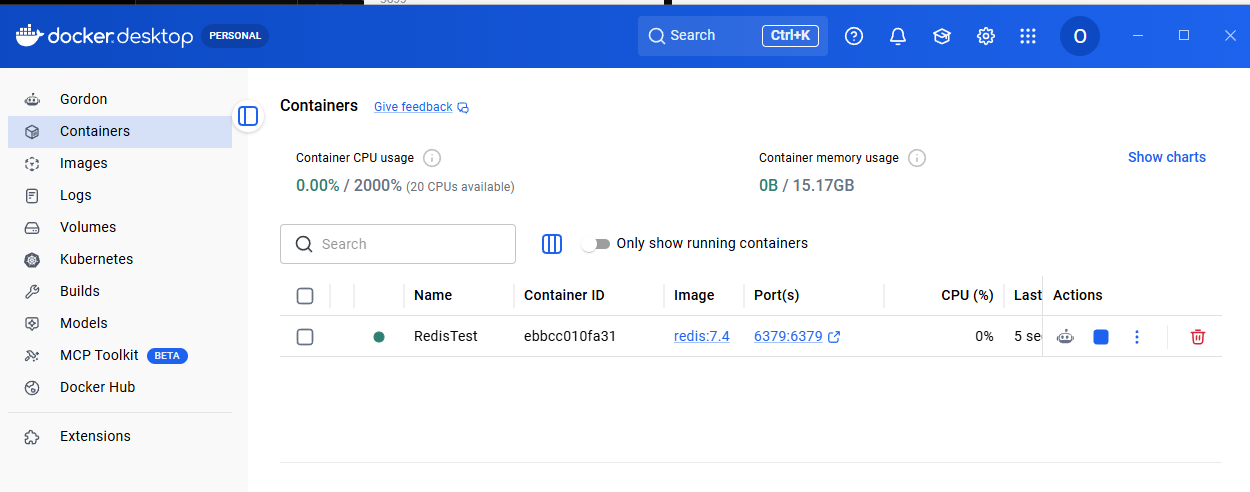
首先需要启动 redis,这里以 docker 作为底层部署 redis 系统。
python 连接 redis 端口实现:
1 2 3 4 5 history = RedisChatMessageHistory("my_session_id1" ,"redis://localhost:6379" ,300
实现调用:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 from langchain_community.chat_message_histories import RedisChatMessageHistoryfrom models import get_lc_model_client"my_session_id1" ,"redis://localhost:6379" ,300 "重复一次" )print (history.messages)print (aimessage)
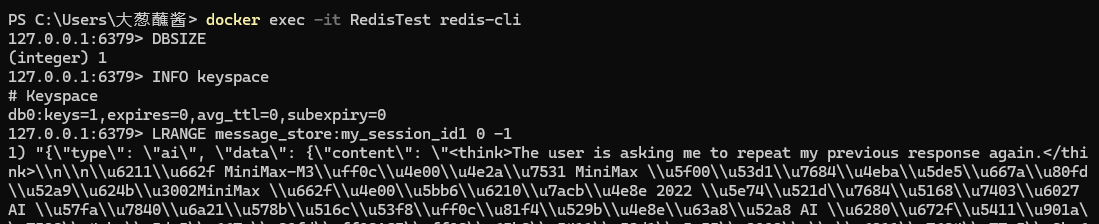
可以直接在 docker 中查看数据。
9.3 记忆自动化管理与保存 RunnableWithMessageHistory 是 LangChain 中实现串联历史记录(记忆)和链,将对话历史自动集成到模型调用链中,解决了聊天机器人在上下文连续性的问题。除此之外还解决了多用户支持中的核心问题。
1 2 3 4 5 6 7 8 9 10 11 from langchain_core.runnables import RunnableWithMessageHistory"input" ,
基于之前的提问框架进行扩展后:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 import osfrom langchain_core.messages import HumanMessagefrom langchain_core.output_parsers import StrOutputParserfrom langchain_core.prompts import ChatPromptTemplate, SystemMessagePromptTemplate, MessagesPlaceholder, \from langchain_core.runnables import RunnableWithMessageHistoryfrom langchain_community.chat_message_histories import ChatMessageHistory, RedisChatMessageHistoryfrom langchain_core.tracers import LangChainTracer, ConsoleCallbackHandlerfrom langsmith import traceablefrom models import get_lc_model_client"你是一个聊天助手,用中文回答所有的问题" ),"{input}" ),''' #ttl 当前会话数据的过期时间,300秒表示5分钟过期 chat_message_history = RedisChatMessageHistory(url=REDIS_URL, session_id=session_id, ttl=300) ''' def get_session_history (session_id ):return RedisChatMessageHistory("redis://localhost:6379" ,300 "input" ,for i in range (4 ):"input" : "我是Tom,我喜欢音乐,你能给我推荐一首轻音乐吗?" },"configurable" : {"session_id" : "Tom" }}print ("用户Tom的回答:" , resp)print ("==================" )"input" : "我是jack,我热爱运动,篮球是我的最爱,你猜我喜欢哪个NBA球星?" },"configurable" : {"session_id" : "jack" }}print ("用户jack的回答:" , resp_jack)print ("==================" )"input" : "我喜欢什么?" },"configurable" : {"session_id" : "Tom" }}print ("用户Tom的回答:" , resp)print ("==================" )"input" : "我喜欢什么?" },"configurable" : {"session_id" : "jack" }}print ("用户jack的回答:" , resp)print ("==================" )