from langchain_core.prompts import ChatPromptTemplate from langchain_core.runnables import RunnableLambda, RunnablePassthrough from langchain_core.documents import Document from langchain_core.vectorstores import VectorStore from langchain_text_splitters import RecursiveCharacterTextSplitter import os
from langchain_openai import ChatOpenAI from langchain.chat_models import init_chat_model from langchain_core.prompts import PromptTemplate # from langchain_core.tools import tool from langchain.tools import tool from models import get_lc_model_client
# api_key 秘钥 model:模型名称 base_url:模型连接的url地址 model = get_lc_model_client()
from dashscope import api_key from langchain.agents import create_agent
from langchain_openai import ChatOpenAI from langchain.chat_models import init_chat_model from langchain_core.prompts import PromptTemplate # from langchain_core.tools import tool from langchain.tools import tool from models import get_lc_model_client
# api_key 秘钥 model:模型名称 base_url:模型连接的url地址 model = get_lc_model_client()
import gradio as gr import os import json import random import subprocess import webbrowser from datetime import datetime from http import HTTPStatus from typing importList, Dict, Any
from langchain.agents import create_agent from langchain_classic.memory import ConversationBufferWindowMemory from langchain_core.messages import SystemMessage from langchain_core.prompts import MessagesPlaceholder, ChatPromptTemplate from langchain_core.tools import Tool
# 验证模型连接 from langchain_community.chat_models import ChatTongyi from langchain_core.messages import HumanMessage from models import get_lc_model_client
model = get_lc_model_client()
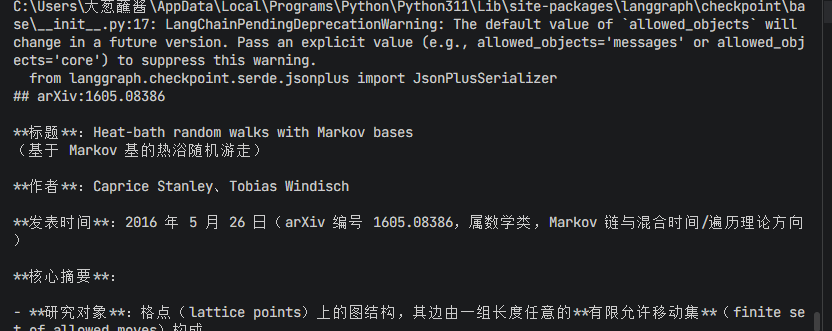
# 构建一个基于arxiv工具的论文查询智能体,实现根据论文编号查询论文信息的功能。 # 使用load_tools()方法导入arxiv工具:class ArxivQueryRun(BaseTool) from langchain_community.agent_toolkits.load_tools import load_tools
from langchain_classic.chains.sql_database.query import create_sql_query_chain from langchain_community.tools import QuerySQLDatabaseTool from langchain_community.utilities import SQLDatabase
from langchain_core.output_parsers import StrOutputParser from langchain_core.prompts import PromptTemplate from langchain_core.runnables import RunnablePassthrough from langchain_openai import ChatOpenAI import re from models import get_lc_model_client
#langchain.debug = True
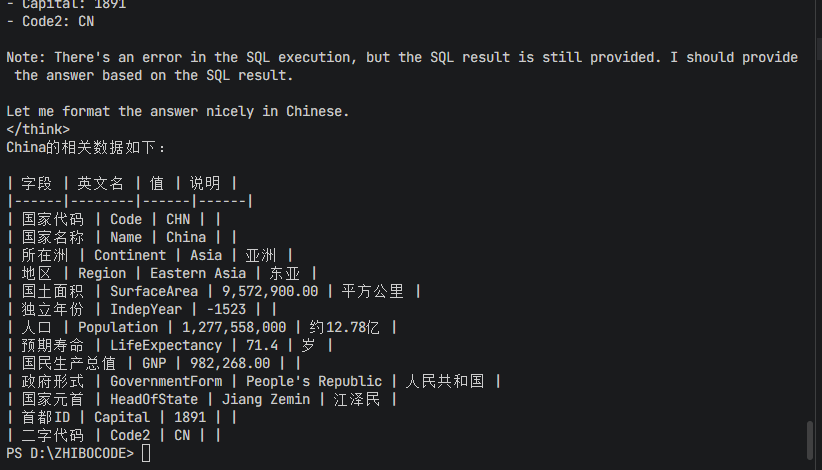
# 使用工具,将自然语言转换成sql,并且执行sql,将查询的结果给模型,然后大模型回复
#获得访问大模型客户端 client = get_lc_model_client()
#数据库配置 pip install mysqlclient mysqlclient==2.2.7 HOSTNAME ='127.0.0.1' PORT ='3306'
# 为了方便,进行简单的配置 DATABASE = 'world' USERNAME = 'root' PASSWORD ='1234' MYSQL_URI ='mysql+mysqldb://{}:{}@{}:{}/{}?charset=utf8mb4'.format(USERNAME,PASSWORD,HOSTNAME,PORT,DATABASE) db = SQLDatabase.from_uri(MYSQL_URI) # # 获取数据库中所有的表名称 # print(db.get_usable_table_names()) # # 执行sql的函数 # print(db.run('select * from country limit 1'))
# exit()
#2、因为实际产生的sql是形如```sql....```的,无法直接执行,所以需要清理 #自定义一个输出解析器SQLCleaner classSQLCleaner(StrOutputParser): defparse(self, text: str) -> str: pattern = r'```sql(.*?)```' match = re.search(pattern, text, re.DOTALL) if match: sql = match.group(1).strip() # 某些大模型还会产生类似'SQLQuery:'前缀,必须去除 sql = re.sub(r'^SQLQuery:', '', sql).strip() return sql # 某些大模型还会产生类似'SQLQuery:'前缀,必须去除 text = re.sub(r'^SQLQuery:', '', text).strip() return text
from langchain.agents import create_agent from langchain.agents.middleware import SummarizationMiddleware, HumanInTheLoopMiddleware from langchain_core.messages import HumanMessage from langchain_core.tools import tool from langgraph.checkpoint.memory import InMemorySaver
from dotenv import load_dotenv from langchain.agents.middleware import before_model, wrap_model_call from langchain.agents.middleware import AgentState, ModelRequest, ModelResponse from langchain.agents import create_agent from langchain_openai import ChatOpenAI from langgraph.runtime import Runtime from typing importAny, Callable from models import get_lc_model_client
from dotenv import load_dotenv from langchain.agents.middleware import before_model, wrap_model_call, AgentMiddleware from langchain.agents.middleware import AgentState, ModelRequest, ModelResponse from langchain.agents import create_agent from langchain_openai import ChatOpenAI from langgraph.runtime import Runtime from typing importAny, Callable from models import get_lc_model_client
import os from dotenv import load_dotenv # 验证模型连接 from langchain_core.messages import HumanMessage from langchain_openai import ChatOpenAI from models import get_lc_model_client
llm = get_lc_model_client()
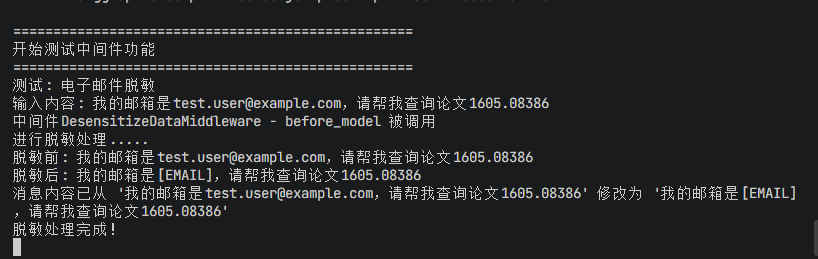
# 创建自定义脱敏中间件 from langchain.agents.middleware import AgentMiddleware from typing importAny, Dict import re # 自定义中间件,中间件实现脱敏的,去除电话号码和邮箱信息 classDesensitizeDataMiddleware(AgentMiddleware): """脱敏中间件"""
def__init__(self, patterns: list = None): super().__init__() self.patterns = patterns or [ (r'[a-zA-Z0-9_.+-]+@[a-zA-Z0-9-]+\.[a-zA-Z0-9-.]+', '[EMAIL]'), (r'(\+86)?1[3-9]\d{9}', '[PHONE]') ]
def_desensitize_text(self, text: str) -> str: # 如果内容为空或已经包含脱敏标记,则跳过处理 ifnot text or'[EMAIL]'in text or'[PHONE]'in text: return text # 快速预检查:只有当可能包含敏感信息时才继续处理 if'@'notin text andnot re.search(r'1[3-9]\d{9}', text): return text print(f"脱敏前: {text}") original_text = text for pattern, replacement in self.patterns: text = re.sub(pattern, replacement, text) # 只有当内容发生变化时才打印 if original_text != text: print(f"脱敏后: {text}") return text
try: # 导入必要的组件 from langchain_community.agent_toolkits.load_tools import load_tools from langgraph.checkpoint.memory import InMemorySaver from langchain.agents import create_agent